地址:朝阳区朝外大街朝外soho乙6号2层0253
邮箱:info@towntour.net
电话:010-58692298
传真:010-58692298
一、一个比融资数字更值得追问的问题
2026年5月,Physical Intelligence完成10.5亿美元C轮融资,投后估值111.9亿美元,累计融资超过21亿美元。投资人名单上有杰夫·贝索斯、OpenAI、红杉资本、Khosla Ventures、Founders Fund。同年,TIME100 AI将联合创始人Chelsea Finn列入榜单。
这些数字足够耀眼。但对于一位真正要做产业决策的中国企业家来说,估值只是背景音,不是答案。
真正的问题是:当π0.7已经能用口述指令让机器人操作一台从未训练过的空气炸锅,当"通才"在叠衣服、做浓缩咖啡这些精细任务上追平甚至超越针对单一任务微调的"专才",机器人基础模型的泛化能力究竟走到了哪一步?离"通用"还有多远?而那道从95%到99%的可靠性鸿沟,究竟是一条可以工程化跨越的沟壑,还是一道尚未被理解的认知断层?
这就是中瑭国际将2026年美国商务考察的核心锚点放在Physical Intelligence旧金山总部的原因。不是去看一段被精心剪辑的demo,而是去追问一个边界问题:泛化的尽头,究竟是通用智能,还是另一种形态的"窄"?

二、π0.7的"涌现":不是更大的模型,而是更聪明的"提问方式"
要理解PI的价值,必须先理解π0.7到底改变了什么。
在π0.7之前,机器人基础模型的训练逻辑本质上与专才模型没有区别:收集某个任务的高质量演示数据,针对这个任务微调,然后得到一个在该任务上表现不错的模型。π0.6时代,PI的模型已经能在叠衣服、组装纸箱等任务上达到高成功率,但每一个新任务仍然意味着新一轮数据采集和专项训练。
π0.7的转折点不在于参数量。它只有约5B参数,VLM骨干是4B的Gemma3,动作专家860M,在基础模型的世界里堪称"轻量"。真正的变化发生在输入端:PI给模型的不再是一句干巴巴的任务指令,而是一套四层结构的多模态上下文prompt——顶层任务指令、子任务语义分解、由世界模型生成的子目标图像、以及每一条训练数据的元数据标签(执行速度、质量评分、是否出错)。
这个设计的精妙之处,用一个类比就能说清楚:过去的机器人模型像一个只读过教科书标准答案的学生,遇到任何偏离标准答案的题目就束手无策;π0.7则被教会了阅读"解题过程"——它知道哪些数据来自一次成功的操作,哪些来自一次失败,哪些来自另一台完全不同的机器人。于是,失败数据从需要被清洗的噪声,变成了"此路不通"的负面教材;低质量演示从被丢弃的对象,变成了"不要这样做"的边界信号。
这带来的能力跃迁是范式性的。在叠衣服任务中,训练数据里没有任何一条来自UR5e机械臂的叠衣样本,π0.7却在UR5e上完成了零样本迁移,任务进度85.6%、成功率80%,与平均拥有375小时遥操作经验的顶级人类操作员(进度90.9%、成功率80.6%)几乎持平,并且自己"琢磨"出了与源机器人不同的垂直抓取策略。在空气炸锅任务中,整个训练数据集里只有两条间接相关的片段——一条是另一台机器人把炸锅推上,一条是开源数据里另一台机器人把塑料瓶放进去——模型却将这些碎片与更广泛的预训练知识合成为对设备功能的理解,在人类分步语言引导下成功完成了烤红薯任务。
Sergey Levine对此的判断是:一旦模型越过那个阈值,从"只能做收集过数据的事"变成"开始重组出新事",能力就会超线性地随数据增长。这正是大语言模型曾经走过的曲线在物理世界中的第一次显影。

三、边界的真相:56%的家务成功率与"最后5%"的重量
但如果就此宣布"通用机器人已经到来",是对产业最大的误读。
π0.7最诚实的价值,恰恰在于它把泛化的边界暴露得足够清晰。
第一个边界是任务复杂度与可靠性之间的反比关系。开箱即用的精细操作——做咖啡、叠衣服、削蔬菜——π0.7已经追平甚至超越RL微调的专家模型,这是真实的突破。但当任务链条拉长、环境不确定性增加时,可靠性迅速衰减。Figure在2026年9月发布的Helix 2.5提供了一个极具参照价值的数字:在30个此前未采集数据的陌生家庭中完成整理客厅、叠毛巾、铺床等完整家务,零样本整任务成功率从无预训练时的9%提升到56%。56%意味着超过一半的尝试以失败告终。而这已经是当前整机+基础模型协同进化所能达到的最好公开水平之一。
第二个边界是"涌现"与"可控"之间的张力。π0.7的研究者自己承认,他们无法准确预测模型在哪些任务上会成功、在哪些任务上会失败。"我过去总能根据训练数据猜出模型能做什么。这一次,我猜不到了。"这种"能力溢出数据"的涌现,在实验室里是令人兴奋的发现,在产线上却是不可接受的变量。Finn本人说得足够坦率:达到99%的成功率"not a solved problem"。从95%到99%的这4个百分点,不是简单的迭代优化,它要求模型在面对分布外场景时具备系统性的鲁棒性,而当前的技术路径尚未证明可以稳定兑现这一点。Levine在2026年8月的访谈中给出了一个更清醒的定位:机器人还没有进入可预测的Scaling阶段,"它还没到GPT-4或GPT-5的阶段"。
第三个边界是prompt依赖的隐性成本。π0.7的空气炸锅实验有一个被广泛忽略的细节:初始尝试的成功率只有5%,经过约半小时的prompt优化后跳到95%。这意味着"零样本"并非零成本——它把一部分工程负担从数据采集和模型训练转移到了任务描述和上下文设计上。当机器人从实验室走向千行百业,谁来承担这笔"prompt工程"的成本?这是模型层企业必须回答的商业化问题,也是整机企业在部署现场必须消化的工程现实。

四、产业分层的真相:PI做"发动机",谁来做"整车"?
理解了泛化的边界,才能理解PI在产业图中的真实坐标。
2026年的具身智能产业正在完成一次静默但深刻的分层。用一位行业观察者的比喻:Figure在造整车,Physical Intelligence在做发动机和底盘平台,DeepMind在定义机器人如何"思考"的那一层。
PI的商业模式选择极为克制:不造硬件,只做"大脑"。它的模型授权给各家机器人厂商,成为跨本体、跨任务的通用智能层。π0.7的跨本体零样本迁移能力——从一个机器人形态迁移到另一个从未见过的形态——正是这一商业模式的技术底座。如果模型只能在特定硬件上工作,"通用大脑"的故事就不成立;如果模型能够跨形态泛化,"大脑"就具备了成为基础设施的条件。
Figure走的则是另一条路:垂直整合。自研Helix模型,自研Figure 03整机,自建Index数据众包平台——全球超过26万次下载、1600万条人类操作视频、每秒新增约35分钟操作记录——再用自有算力和自有产线完成闭环。Helix 2.5的56%零样本家务成功率,是这个闭环在真实场景中跑出来的成绩单。Figure不需要模型层的"通用",它需要的是在自己的整机上、在自己的目标场景中,把可靠性推到可交付的水平。
两者之间不是简单的"竞"或"合"。PI的护城河在于"跨"的广度:如果"通用大脑"的命题成立,任何一家整机企业都可以是PI的潜在客户,模型层的规模效应来自跨客户、跨形态的数据飞轮。Figure的护城河在于"深"的厚度:整机、数据、模型、算力的垂直咬合,让它在特定场景的端到端性能上具备模型层企业难以复制的工程纵深。竞合的演变方向,取决于一个尚未被回答的问题:未来机器人产业的价值池,是集中在"大脑"层,还是分散在"整机+场景"层?π0.7和Helix 2.5分别代表了两种押注,而2026—2027年将是两种路径接受真实场景检验的关键窗口。
五、为什么必须去现场:隔着屏幕看不见的"边界感"
关于Physical Intelligence和π0.7,中文互联网上已经有足够多的技术解读。知乎上有详细的prompt架构分析,量子位给出了"机器人的GPT-3时刻"的判断,TechCrunch记录了研究者自己"被模型惊到"的瞬间。
但所有这些二手信息,都无法替代一件事:站在π0.7的demo现场,亲眼看到它在哪里成功、在哪里失败、以及研究者如何谈论那些失败。
这正是中瑭国际设计这次Physical Intelligence旧金山总部深度参访的底层逻辑。中瑭国际在过去数年间组织过数十场美国AI与高科技商务考察,一个被反复验证的判断是:当一位企业决策者真正站到技术发生的一线,他对一项技术的理解会发生质的变化——从"它有多厉害"变成"它的边界在哪里,我的生意应该站在边界的哪一侧"。
在PI总部的交流中,中瑭国际将引导参访者把注意力集中在三个"只有当面才能追问出深度"的问题上:
第一问:泛化的"质"与"量"之间,是否存在一个可工程化的拐点? π0.7证明了组合泛化可以"涌现",但涌现的可重复性、可预测性、可定价性,是模型层商业化的真正瓶颈。研究者对"模型会什么、不会什么"的认知边界,比任何benchmark数字都更能说明这项技术离规模部署还有多远。
第二问:模型层企业与整机企业的分工,正在收敛还是分化? PI的"大脑"路线和Figure的"整车"路线,在2026年同时取得了标志性进展。但两者的数据飞轮逻辑、客户关系、价值捕获方式截然不同。对于正在考虑切入机器人赛道的中国企业而言,选择站在哪一层,比选择做什么产品更根本。
第三问:从95%到99%,这"最后几个点"的路径依赖是什么? 是更多数据、更大算力、更好的prompt设计,还是需要一次方法论层面的跃迁?这个问题的答案,直接决定了当前对机器人基础模型的投入节奏:是应该"加速押注",还是应该"在正确的节点上等待"。
六、考察主题的落点:不是去验证一个答案,而是去校准一套判断
这次考察的主题定为 《π0.7的泛化边界:机器人基础模型离"通用"还有多远?》 ,其用意不在于给出一个"是"或"否"的结论。
π0.7已经证明的事情足够重要:组合泛化可以在机器人领域发生,通才可以追平专才,跨本体迁移可以逼近人类遥操作水平。这些是真实的、可复现的、已经写入技术报告的进展。但同样真实的是,56%的零样本家务成功率、尚未解决的99%可靠性问题、以及Levine"还没到GPT-4阶段"的自我定位,共同划出了一条清晰的边界。
对企业家而言,最有价值的信息从来不是"这项技术有多好",而是"这项技术的边界在哪里,以及边界之外还有多远"。 隔着太平洋读一百篇分析,不如在旧金山的总部里待一个下午,听做模型的人亲口说出"我们也不知道它什么时候会成功、什么时候会失败"——然后自己判断,这个"不知道"在你的行业里值多少钱,又值不值得你现在下注。
中瑭国际的美国商务考察,本质上提供的是一种认知校准:在具身智能从"演示叙事"转向"部署叙事"的转折年份,把决策者带到叙事转换发生的第一现场。当π0.7的泛化边界被亲眼看见、亲手追问、当面校准之后,关于"要不要做机器人基础模型""做哪一层""用什么节奏做"的答案,会变得比任何二手报告都更清晰。
因为真正的战略判断,从来不是在信息最充分的时候做出的,而是在边界最清晰的时候做出的。 而边界,必须去现场看。
中瑭国际·美国商务考察
主题:π0.7的泛化边界——Physical Intelligence旧金山总部深度参访
核心议题:机器人基础模型的泛化进程、可靠性弥合路径、模型层与整机层的竞合逻辑
本考察行程为中瑭国际美国AI与机器人产业考察系列之一,可根据企业需求定制参访模块与交流议程。
国际专家智库
INTERNATIONAL THINKING TANK
作为直接服务于中国企业转型升级、创新变革的平台,中瑭国际建立资深专家智库,以工业4.0,智能制做等课程的讲授、主题会谈、交流分享等方式让中国企业目瞻前沿、论道全球。
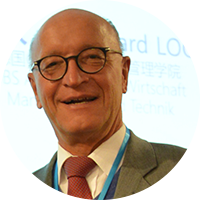
德国联邦议会议员德国联邦基督教民主青年团执行委员德国执政党(CDU)慕尼黑中产阶级联合会地区主席德国基督教民主青年团拜仁州主席
路德维希堡金融大学硕士 税务金融教授 Pro Tax税务事务所所长
犹太贵族家庭出身 德国文化经济促进会担任主席、董事长 德国基民盟经济委员会委员

创办法兰克福律师事务所至今已有20多年,有着丰富的经验,已成功的处理大大小小案件几千例,大多都是与企业相关,兼任很多企业的法律顾问。
GBS学院讲师 GBS学院教授
GBS学院讲师 GBS学院教授
GBS学院讲师 GBS学院教授
海德堡大学讲师、教授
金门大学教授
金门大学会计学院院长
金门大学商学院院长
金门大学杰出兼职教授
运营与IT管理副教授兼系主任

东京大学 副教授,经济学博士
原小松制作所社长

丰田财团董事长
 >
软银集团孙正参谋
京瓷咨询事业部部长
耶路撒冷政策研究协会 项目经理、研究员

芝加哥大学工商管理博士
哥伦比亚大学博士
特拉维夫大学博士
美国西北大学数学博士学位 巴伊兰大学塔木德博士学位 科特勒犹太教与当代思想研究所主任
剑桥商学院教授
剑桥大学贾吉商学院教授
剑桥大学贾吉商学院教授
剑桥大学商学院教授
剑桥创新投资中心主席
剑桥大学贾吉商学院金融学副教授
剑桥大学贾吉商学院经济学副教授
剑桥大学贾吉商学院组织行为学讲师
剑桥大学贾吉商学院大数据分析及定量社会科学讲师
剑桥大学教授
剑桥大学教育系教授
剑桥大学招生录取委员会主席
剑桥大学教育系教授
剑桥大学教育系教授
新加坡国立大学 讲师
新加坡国立大学 讲师
俄罗斯图拉市政府投资促进局代表
俄罗斯图拉市政府投资促进局代表

台湾 新世纪形象管理学院 创办人
台湾 新世纪形象管理学院 讲师
台湾 新世纪形象管理学院讲师
全球合作资源
GLOBAL COOPERATION RESOURCES
十余年的项目经验和口碑,奠定了与全球六十多个国家的广泛联络和友好的合作,得到全球各顶尖大学、知名企业、各国政府商务部门、各行业协会与商会等多家海外组织与机构支持,为中国国内各界提供真正专业的一站式海外商务考察和培训服务。
 GBS学院
 海德堡大学
 慕尼黑工业大学
 德国中小企业联合会
 弗劳恩霍夫协会
 奔驰
 SAP软件公司
 MPDV公司
 西门子
 博世集团
 斯坦福大学
 金门大学
 哈佛大学
 旧金山市政府
 洛杉矶市政府
 美联储
 高盛集团
 GOOGLE
 苹果
 FACEBOOK
 东京大学
 早稻田大学
 东京卫生学园专门学校
 日本国立癌症研究中心
 社会福祉法人长寿村
 软银集团
 朝日啤酒工厂
 丰田汽车整车厂
 京瓷株式会社
 积水住宅株式会社
 特拉维夫大学
 耶路撒冷经济研究院
 魏茨曼科学研究院
 JVP基金
 OurCrowd公司
 IronSource 公司
 Adnimation 公司
 InfinityAR 英菲尼迪
 AZROM 阿森沃亩
 Netafim LTD 奈特菲姆
 巴克莱银行
 瑞银集团
 瑞致达集团
 Smith & Williamson 独立理财机构
 隆奥达亨银行
 伦敦证卷交易所
 英格兰银行
 汇丰银行
 渣打银行
 P2PGI全球投资平台
 英国行为监管局
 Prodigy Finance助学贷款公司
 RateSetter P2P借贷平台
 帝国理工大学大数据实验室
 APS Financial
 牛津大学Nie金融大数据实验室
 Zopa
 Saxo Bank
 TransferWise
 FundingKnight
 Seedrs
 Funding Circle
 PayPal
 Level 39
 法国·巴黎高等商学院
 法国·巴黎第一大学
 法国·巴黎地区市政府
 法国·联合国教科文组织
 法国·迪奥
 法国·家乐福
 法国·路易威登
 法国·爱马仕
 法国·欧莱雅
 新加坡·国立大学
 新加坡·管理大学
 新加坡·市区重建局
 新加坡·嘉德置地
 新加坡·仁恒地产
 新加坡·远东机构
 俄罗斯·圣彼得堡大学
 俄罗斯·莫斯科大学
 俄罗斯·图拉市政府投资促进局
 俄罗斯·俄罗斯工业通讯银行
 俄罗斯·Yandex
 俄罗斯·X5 Retail Group
 瑞士·苏黎世大学
 瑞士·苏黎世联邦理工大学
 瑞士·瑞中经济协会
 瑞士·伯爵
 瑞士·江诗丹顿
 瑞士·宝盛银行
 瑞士·联合银行集团
 台湾·新世纪形象管理学院
 台湾·建筑美学文化经济协会
 台湾·半导体产业协会
 台湾·台塑石化
 台湾·国泰金控
 台湾·南亚科技
 台湾·宝佳机构
SUCCESSFUL CASE
成功案例
中瑭国际与德国、美国、日本、以色列等发达国家的众多政府机构、企业、高校、研究所等建立了长期稳定的合作伙伴关系。为您提供最实效的培训及考察方案,助力中国企业走出去,学习全球领先的管理和技术。


英国剑桥大学培训及金融主题考察成功案例视频 PART1
英国剑桥大学培训及金融主题考察成功案例精彩集锦 PART2
第六帝国”罗斯柴尔德家族庄园深度考察视频集锦,并与罗斯柴尔德爵士
英国顶级法学院考察视频,深入了解英国教育及文化
特莱德游学携手碧桂园日本房地产行业考察:野村不动产调研参访
特莱德游学带您参访欧洲最先进的太阳能住宅小区:德国弗莱堡“太阳船
特莱德游学带您参考世界最大的专业门窗五金系统制作商:德国诺托集团
特莱德游学带您参访德国顶级橱柜品牌 劳斯
特莱德游学带您走进未来--美国硅谷创新游学 斯坦福大学:叶教授专题
HOT RECOMMENDATION
精选全球资源
中瑭国际以全球创新大变革时代为背景,精选全球优质项目,秉持“全球智慧助推中国企业创新与变革”的理念,致力于满足企业商务考察需求,共享全球“制”慧。
 中瑭国际战略合作伙伴德国GBS学院专题
 日本制造的高品质为什么深植人心?中瑭国际带您寻找答案!
 中瑭国际优势链接德国政府,名企名校资源,竭诚打造德国商务考察项目
 一次寻找商机之旅,一场信仰文化之行---以色列商务考察,只为等你来
 自由至上,勇于尝试,中瑭国际美国商务考察旅游,在这里,遇见你
 中瑭国际商务考察专题
 010-58692958
 18612017571